Étude de cas · R&D données

Des données publiques traçables jusqu'à leur source.

Un projet de recherche personnel : rassembler des déclarations financières publiques américaines, éparpillées dans des formats différents, dans une seule base où chaque ligne renvoie au document officiel.

Prototype fonctionnel, juin 2026
terminal
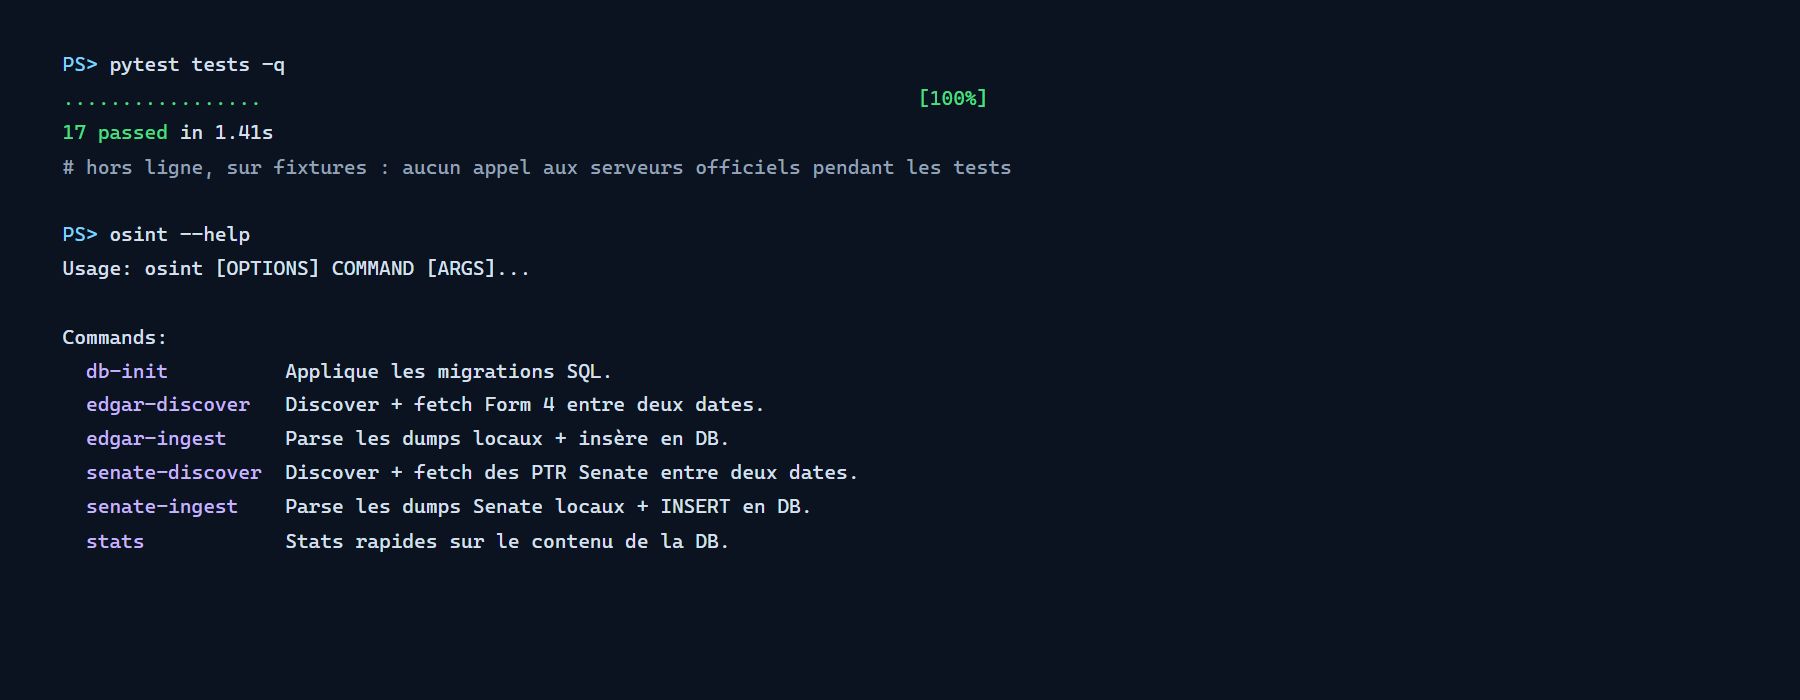
Terminal : les 17 tests passent hors ligne, puis la liste des commandes de l'outil (initialiser la base, collecter, intégrer, statistiques)
Sortie réelle du terminal
2sources officiellesSEC (Form 4) et Sénat américain
17tests hors lignesur fichiers d'exemple
6commandesde la base aux statistiques
0champ « recommandation »l'outil observe, il ne conseille pas
Le contexte

Des données publiques, mais dispersées.

Aux États-Unis, les dirigeants d'entreprises cotées et les sénateurs doivent déclarer certaines transactions. Ces déclarations sont publiques, mais chaque source a son format (XML, pages HTML, PDF scannés), ses délais légaux et ses fourchettes de montants plutôt que des valeurs exactes.

L'outil les rassemble dans un schéma unique pour l'analyse personnelle, dans le cadre légal américain qui encadre leur réutilisation : pas d'usage commercial, pas de recommandation. Cette fiche décrit la méthode ; elle ne montre aucune donnée réelle ni aucun déclarant.
Ce qui a changé

Une base où chaque ligne se vérifie.

Trois formats selon la sourceUne table unique, quelle que soit l'origine
Une donnée dont on ne sait plus d'où elle vientL'adresse du document officiel, obligatoire sur chaque ligne
Relancer une collecte crée des doublonsIdentifiants déterministes : relancer met à jour
Un champ douteux complété au jugéLigne signalée pour relecture humaine
Comment ça marche

Cinq couches, chacune rejouable seule.

  1. 1CollecteTéléchargement seul, débit limité sous le plafond officiel, copie locale horodatée.
  2. 2LectureLe fichier téléchargé devient des données brutes. Testable sans réseau.
  3. 3NormalisationSchéma commun, délai entre transaction et publication calculé et stocké.
  4. 4BasePostgreSQL, requêtes SQL écrites à la main, migrations versionnées.
  5. 5AnalyseUne ligne de commande pour les statistiques. Le rapprochement reste un travail humain.
À l'écran

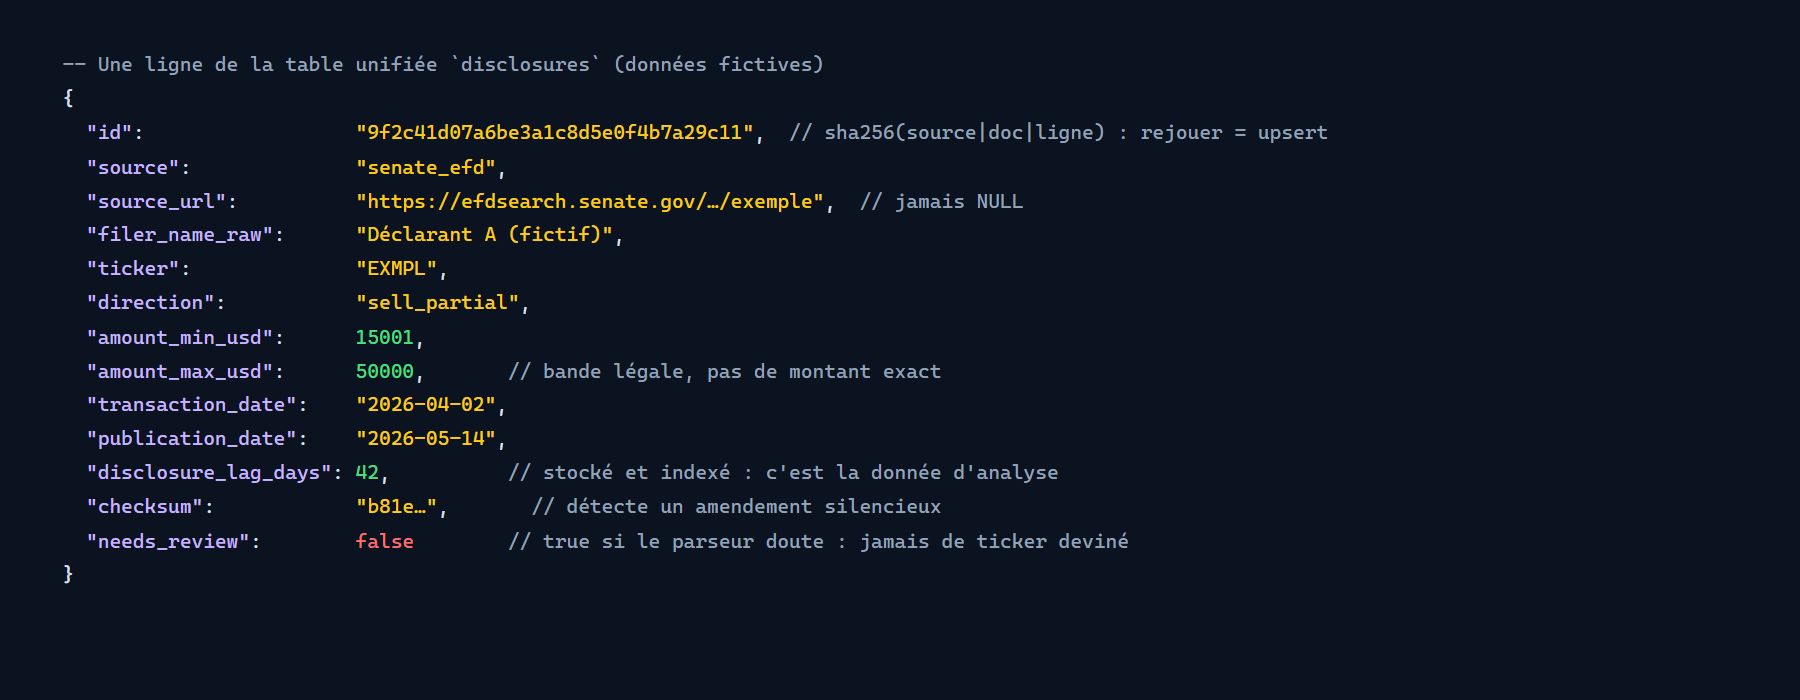
Un enregistrement, champ par champ.

schéma unifié
Exemple d'enregistrement normalisé avec des données fictives : source, adresse officielle, fourchette de montant, délai de publication, empreinte et drapeau de relecture
Une ligne de la table commune, remplie avec des données fictives.
Les choix qui comptent

Rigueur d'abord, débit ensuite.

Chaque couche se rejoue seule

La collecte ne touche pas la base, la lecture ne télécharge rien. On peut corriger un parseur et relire des mois de fichiers sans rien retélécharger : la donnée d'origine est conservée.

Le doute est une donnée

Quand une fourchette de montant n'est pas standard ou qu'un symbole boursier manque, la ligne est marquée « à relire », avec la raison. L'outil ne devine jamais.

L'outil signale, il ne recommande pas

Aucune colonne de conseil, aucun branchement à un courtier. L'outil expose des faits datés, chacun relié à sa source : l'interprétation reste humaine, comme l'exige le cadre légal.

StackPython 3.12httpxtenacityPydanticClickPostgreSQL 16psycopg 3Docker Composepytest

Des données publiques à rassembler et fiabiliser ?